11|Markdown 版的 jq(harehare/mq)
🎯 一句話:mq 本身是個獨立的 Rust CLI(Markdown 版 jq),repo 裡順手帶了
skills/兩個 Skill,教 Agent 怎麼用它的查詢語法處理 Markdown、爬網頁。
- Repo:https://github.com/harehare/mq(MIT)
- 文件:mqlang.org/book|Playground:mqlang.org/playground
- 安裝:
curl -sSL https://mqlang.org/install.sh | bash,或brew install mq/cargo install mq-run/ Docker(ghcr.io/harehare/mq) - 相容:CLI 工具本身跟 Agent 無關,
skills/底下兩個 Skill 是給 Claude Code 等能讀SKILL.md的 Agent 用
🤖 直接請 Agent 安裝
看不懂底下的指令沒關係,把整段貼給你的 Agent(Claude Code/Cursor/Codex 等)即可:
請幫我裝 harehare/mq 這個 Markdown 查詢工具,以及它附帶的兩個 Skill:

1. 安裝 mq 本體:`curl -sSL https://mqlang.org/install.sh | bash`(或用 brew / cargo,看我機器上已裝的套件管理工具)。
2. 把 https://github.com/harehare/mq 的 skills/processing-markdown/ 與 skills/web-scraping/
   兩個資料夾複製進我專案的 .claude/skills/。
3. 裝完後跑 `mq --version` 確認可用,並列出這兩個 Skill 的 SKILL.md 開頭
   frontmatter(name/description),確認觸發詞抓得到。
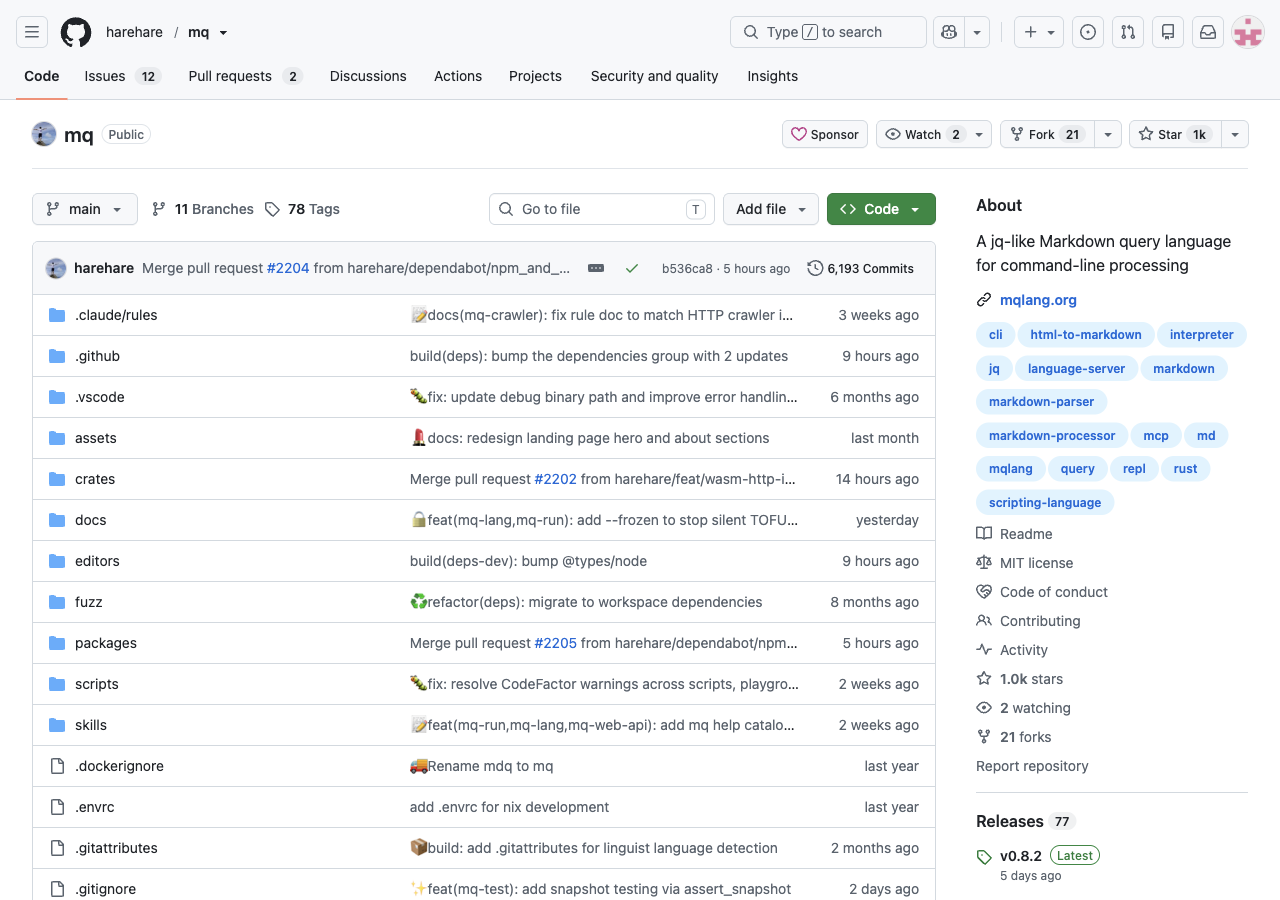
repo 頁面右側 About 就把定位講完:「A jq-like Markdown query language for command-line processing」,1k+ star、21 fork、6,193 次 commit——skills/ 只是這個活躍工具的其中一個資料夾,不是收藏的重點。
跟本站收藏的其他來源不同,mq 不是一個「Skill 收藏 repo」——它是一個獨立可用的 Rust CLI 工具,用 jq 的語法哲學(select / map / filter / pipe)處理 Markdown 的 AST,而不是純文字正則。作者 harehare 把它做成一個小型查詢語言:.h、.code、.link 這類 selector 對應 Markdown 節點類型,可以組合、過濾、轉換,再用 -F json / -F table 這類 flag 輸出成別的格式。skills/ 目錄只是這個工具裡順手為 Agent 準備的兩份用法說明書,收進本站是因為它示範了「CLI 工具作者自己寫 Skill,教 Agent 用好自己的工具」這個模式——跟前面 09 HyperFrames(影片框架自帶 Skill)是同一路數。
這個工具在解決什麼問題
Agent 處理 Markdown 常見的做法是整段讀進 context 再用文字模式比對,既浪費 token 又容易抓錯邊界(例如把程式碼區塊裡長得像標題的字串當成標題)。mq 把 Markdown 解析成結構化節點后再查詢,Agent 只要下一行查詢語句,就能精準拿到「所有二級標題」「所有帶 TODO 的程式碼區塊」「所有連結的 URL」,不用把整份文件塞進 prompt。README 明確把「LLM workflows」列為使用情境之一:在 LLM 的輸入輸出裡操作 Markdown、產生給模型讀的結構化輸入。
兩個 Skill
processing-markdown
| 項目 | 內容 |
|---|---|
| 觸發時機 | 使用者提到 Markdown 處理、內容擷取、文件轉換,或直接講 mq 查詢 |
| 核心流程 | ① 用 dot-notation 選節點(.h 標題、.code 程式碼區塊、.link 連結…)② select() 依條件過濾(例如 contains('TODO'))③ 用 pipe 接 to_text 等函式轉換,或用 |= 原地更新 ④ CLI flag 控制輸入輸出(-A 聚合多檔、-F 輸出格式、-I 輸入格式、-U 直接更新檔案)⑤ 依節點類型取屬性(標題層級、程式碼語言、連結 URL、圖片 alt…) |
| 不該用的場合 | 二進位檔案、不需要轉換的單純輸出、非 Markdown 的結構化資料(那種該用 jq/yq) |
web-scraping
| 項目 | 內容 |
|---|---|
| 觸發時機 | 需要抓網頁、擷取結構化資料、爬站,或把 HTML 轉成 Markdown/JSON |
| 三個工具 | mq-crawl(抓取/爬取 URL 成 Markdown,支援 JS 渲染、多頁爬取、robots.txt)、mq(用類 jq selector 過濾轉換 Markdown 或 HTML)、mq 內建的 http() 函式(查詢裡直接發 POST 或帶自訂 header) |
| 基本用法 | mq-crawl --depth 0 https://example.com;接查詢:mq-crawl --depth 0 -q '.h | to_text()' https://example.com |
| 進階情境 | JS 渲染頁面加 --headless --headless-network-idle;多頁爬取設 --depth 2 搭配 --allowed-domains;自訂請求用 mq --allow-net 'http("post", "url", "body")';要繞過 Markdown 轉換直接查 HTML 用 css() / css_text() / css_attr() |
| 已知限制 | 拿不到 HTTP 狀態碼/header;要打 API 該用 curl 配 mq -I json,不要硬套這兩個工具 |
值得抄的一件事
Skill 不一定要獨立收藏成庫,工具作者可以把「怎麼用好我的工具」直接寫成 Skill 放進自己的 repo。 mq 的兩個 Skill 都不是抽象方法論,而是緊貼 mq 自己的 CLI flag 與 selector 語法——這種「工具 + 用法說明」綁在一起發布的模式,比使用者自己事後摸索一套 prompt 更可靠,也更容易隨工具版本一起更新。